磁盘告警是运维最常见的问题之一。本文给出一套固定的三步排查法:df 定位分区 → du 下钻目录 → find 精确抓大文件,外加两个经典坑(已删除未释放、挂载点覆盖)的处理。
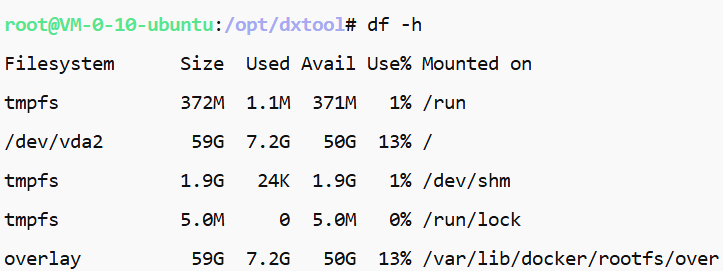
第一步:df 看哪个分区满了
df -h
看 Use% 列,找到 90% 以上的分区(一般是根分区 / 或数据盘 /data)。注意两种特殊情况:
- inode 耗尽:
df -h显示空间还有,但写入报 No space left on device——执行df -i看 IUse%,大量小文件(如 session 文件、邮件队列)会把 inode 吃光 - ** overlay / tmpfs 异常**:容器环境的 overlay 分区满了,通常对应宿主机 docker 目录(见前文 Docker 清理篇)
第二步:du 逐层下钻
进入满的分区对应挂载点,从顶层往下找:
cd /
du -sh * 2>/dev/null | sort -rh | head -20
这条命令列出根目录下各目录的大小并按大小排序。2>/dev/null 屏蔽权限报错,sort -rh 让 4.2G / 380M 这样的人类可读数值正确排序。
找到最大的目录后 cd 进去重复执行,一般两三层就能定位到具体业务目录。常见的空间大户:应用日志、临时文件目录、旧版本包备份、/var/log、/var/lib/docker。
排除挂载点干扰:如果系统里有 NFS 等网络挂载,du -shx 的 -x 参数可以只统计当前文件系统,避免把挂载盘算进来。
第三步:find 精确抓大文件
知道目录了,最后一步找出具体是哪些文件:
# 当前目录下找出大于 500MB 的文件,按大小列出
find /var/log -type f -size +500M -exec ls -lh {} ;

# 找出 7 天内修改过且大于 100MB 的文件(最近活跃的大文件优先处理)
find / -xdev -type f -size +100M -mtime -7 -exec ls -lh {} ; 2>/dev/null

# 找出最大的 20 个文件(xargs 配合 du 汇总排序)
find / -xdev -type f -print0 2>/dev/null | xargs -0 du -h 2>/dev/null | sort -rh | head -20
处理文件时优先考虑「删旧 + 截断」:
# 日志类大文件:清空而不是删除(避免进程句柄问题,见下文坑一)
truncate -s 0 app.log

# 已压缩的历史日志直接删
rm /var/log/app/app-2025-*.gz
坑一:文件删了,空间没释放
rm 掉大日志后 df -h 纹丝不动?文件被进程持有句柄时,删除只是断开目录项,数据块要等进程关闭文件才释放:
# 找出已被删除但仍被占用的文件
lsof +L1 | sort -k7 -rh | head

# 处理方式:重启对应进程;或对日志类先 truncate 再 rm
truncate -s 0 /var/log/app/app.log
所以生产环境清理日志的正确姿势是 truncate 清空,而不是直接 rm。
坑二:du 和 df 数字对不上
du 统计的总量远小于 df 显示的已用空间,除了坑一的句柄问题,还有一种可能是文件被删除时正处于挂载点之下——先卸载或移开挂载点再排查挂载目录下的残留文件。
治本建议
- 日志轮转:logrotate 配置按天切割 + 保留 7~15 天
- 业务临时文件定时清理脚本 + cron
- 磁盘告警阈值设两档:80% 预警、90% 告警,留出处理时间
日常用到的文件查找、日志处理命令可以收藏速查表:Linux 命令速查。