接口收到的中文参数变成了乱码或一串 %XX?搜索关键词里的加号变成了空格?本文讲清 URL 编码的规则与历史包袱,并给出一套快速定位「编码问题出在哪一环」的方法。
先理解:URL 里哪些字符是合法的
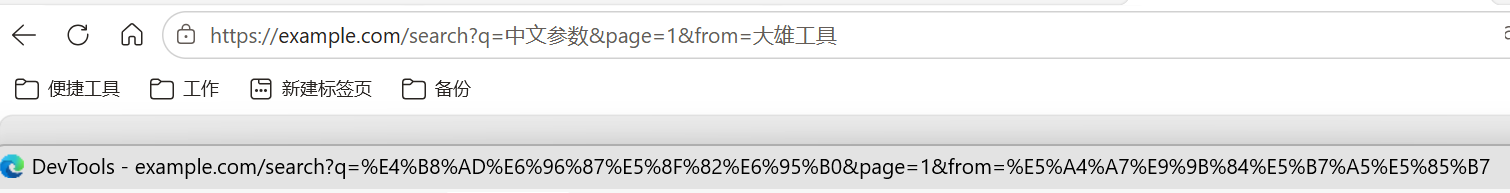
URL 规范(RFC 3986)只允许字母、数字和少量保留字符(- _ . ~ 以及各类分隔符 : / ? # [ ] @ ! $ & ( ) * + , ; =)。中文、空格、emoji 等所有其他字符必须转成 %XX 十六进制序列(UTF-8 字节逐个转义),比如:
搜索「大雄」 → %E5%A4%A7%E9%9B%84 (「大」的 UTF-8 三字节 E5 A4 A7)
浏览器地址栏里你能直接看到中文,那是浏览器的显示优化,实际请求发出去的都是编码后的字节。
经典坑一:+ 号与 %20 的历史包袱
空格在 URL 里有两种编码:%20(RFC 3986 标准)和 +(HTML 表单 application/x-www-form-urlencoded 约定)。两者不对称的转换规则就是大量 bug 的源头:
- Java 的
URLEncoder.encode()按表单编码规则走,空格变+ - JavaScript 的
encodeURIComponent()按标准走,空格变%20 - 服务端按表单规则解码时,
+会被解成空格
于是出现经典事故:参数值里本身包含 + 号(如邮箱 a+b@test.com、手机号 +8613800000000),发送前被正确编码成 %2B,但中间某一环节「手贱」多做了一次解码,%2B 变回 +,再被下一环节按表单规则解码成空格——加号消失。
原则:编码一次,解码一次,环节间传递已编码的值。 前端拼接 URL 时用 encodeURIComponent()(它会编码 + 为 %2B),不要用 encodeURI()(后者不处理 & = + 等保留字符,只适合编码完整 URL)。
经典坑二:双重编码
字符串被编码了两次:大 → %E5%A4%A7 → %25E5%25A4%25A7(% 本身被编码成 %25)。服务端解一次码得到 %E5%A4%A7,看起来还是乱码。
判断方法:看到 %25 开头(或参数里有 %3D、%26 这类保留字符的编码)就是双重编码。常见成因:
- 框架已自动编码,业务代码又手动 encode 了一次
- 重定向链路中每一跳都编码一次
- 网关 / 代理层与业务层各做了一次编码
排查四步法
- 看原始请求:浏览器 DevTools → Network → 找到该请求,Payload / Query String Params 里切换 raw 与 decoded 视图,确认发出侧编码是否正确
- 逐环节对比:网关日志 → 服务访问日志 → 应用收到的参数,找出在哪一环由「正常编码」变成了「异常值」
- 验证解码次数:把异常值手动解码两次对照,确认是双重编码还是字符集问题
- 区分乱码类型:
%XX序列是编码问题(解少了或解多了);固定样式的花字符(如 涓枃)是 UTF-8 字节被按 GBK 解读,属于字符集问题,检查Content-Type与服务端解码 charset
Java 侧的正确姿势
// 构造查询参数:用 java.net.URLEncoder(注意它是表单编码,空格变 +)
String encoded = URLEncoder.encode(value, StandardCharsets.UTF_8);

// 服务端解码:Spring 直接接收即可;手动解码用 URLDecoder
String decoded = URLDecoder.decode(encoded, StandardCharsets.UTF_8);
注意 URLEncoder.encode(String, String) 的旧单参重载已废弃,务必显式传 UTF-8。Spring MVC 场景下 query 参数交给框架绑定,不要自己再 decode 一次——那是双重解码的主要来源。
快速验证工具
排查时经常需要把一段参数编码 / 解码对照看,可以直接用在线工具:URL 编解码工具。涉及 Base64 传输参数(如 token 里带 Base64,其中的 + / = 也需要 URL 安全处理)时配合 Base64 编解码工具 验证,Base64 出现在 URL 里建议使用 URL 安全变体(- _ 替代 + /)。