Base64 的 5 个坑:不是加密、URL-safe、换行、中文编码、JWT 变体
Base64 的五个常见误解:它不是加密、URL-safe 变体的区别、换行影响解码、中文要先转 UTF-8、JWT 里的变体格式。逐个给出错误现象与正确写法,排查乱码和解码失败时可直接对照,也说明长度膨胀比例与填充符的作用。浏览器控制台、命令行和常见语言库的写法都给出示例,复制后即可验证问题出在哪。
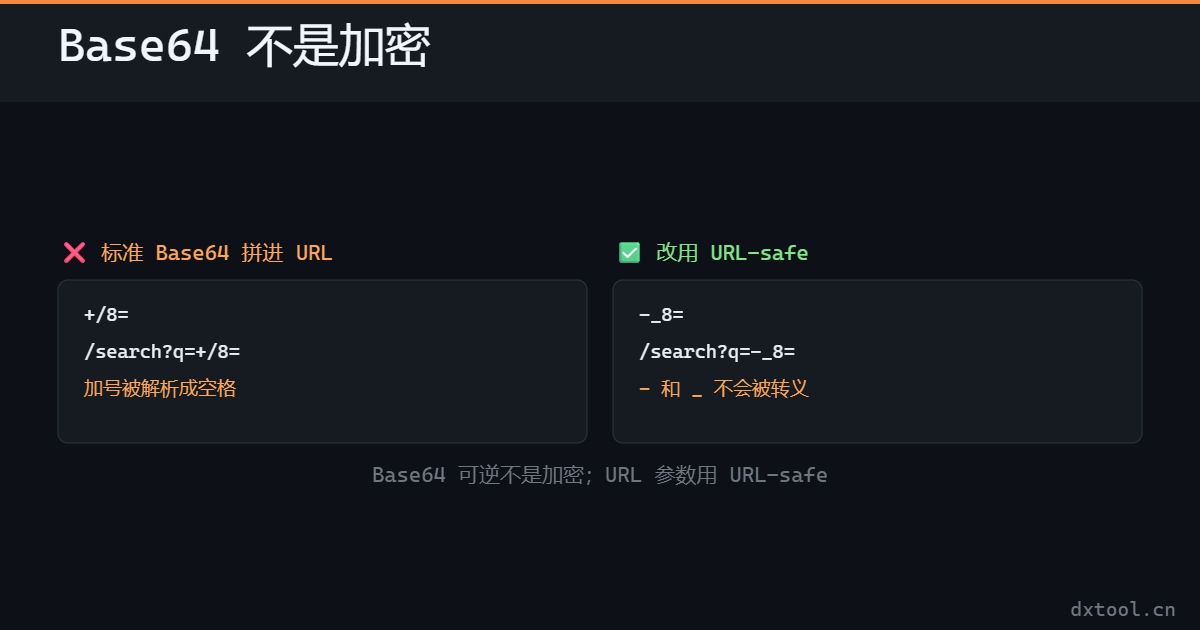
Base64 的五个常见误解:它不是加密、URL-safe 变体的区别、换行影响解码、中文要先转 UTF-8、JWT 里的变体格式。逐个给出错误现象与正确写法,排查乱码和解码失败时可直接对照,也说明长度膨胀比例与填充符的作用。浏览器控制台、命令行和常见语言库的写法都给出示例,复制后即可验证问题出在哪。
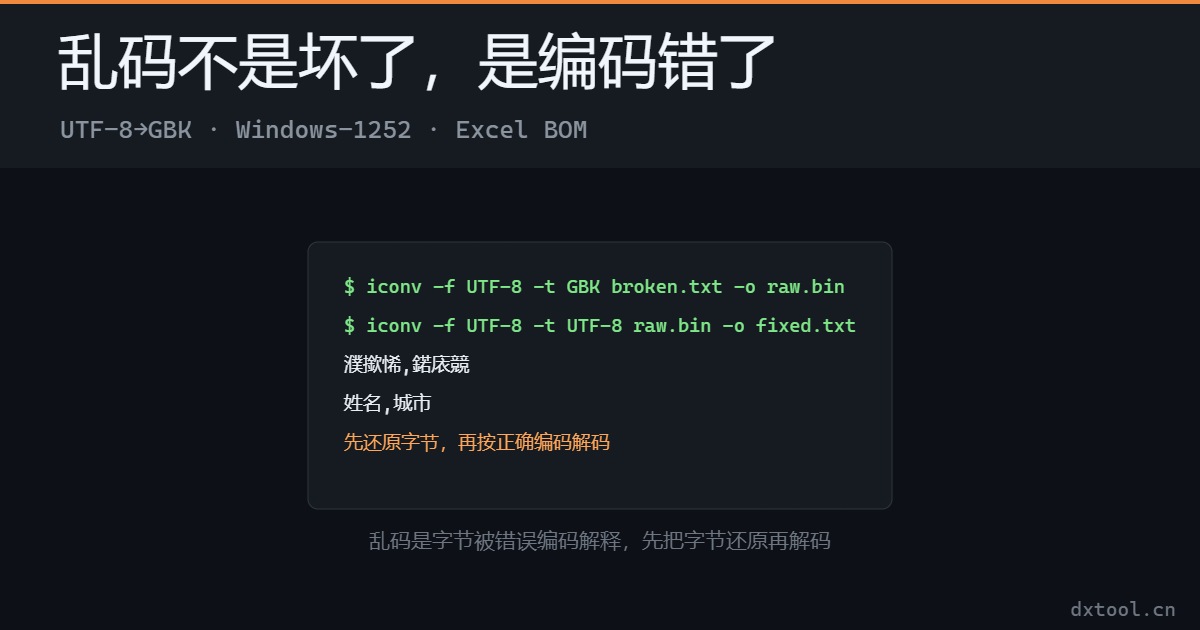
乱码的成因是字节没变、解码用的编码错了。文章用 Python 与 iconv 复现两条常见路径:UTF-8 字节被 GBK 打开得到濮撳悕,被 Windows-1252 打开得到 测试,并给出反向往回编码再解码的修复公式;再解释 Excel 打开 CSV 为何要 UTF-8 BOM、脚本与 JSON 为何不要。
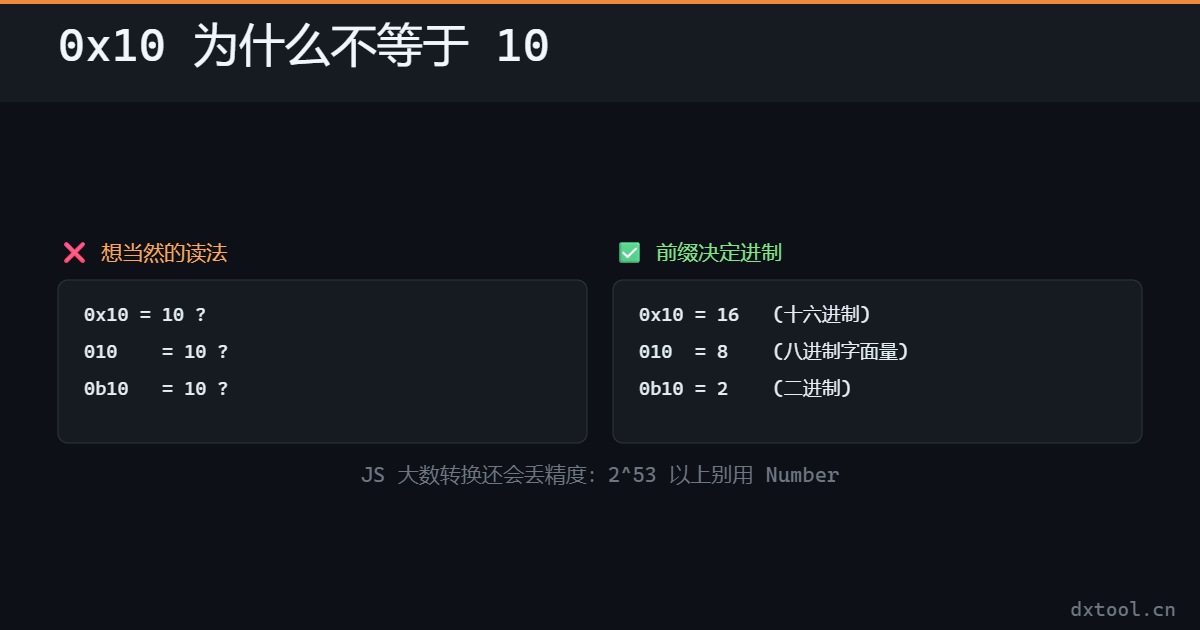
进制转换踩坑:0x10 为什么是 16、前导零为什么变成八进制、parseInt 不带进制参数为什么会猜错。文章用 Node、Python、Java 实测同一段代码的输出差异,讲清 JS 大数精度丢失与负数补码口径,附在线进制转换工具与逐条验证方法,排查配置值、权限位、颜色值与编码场景时可直接对照。
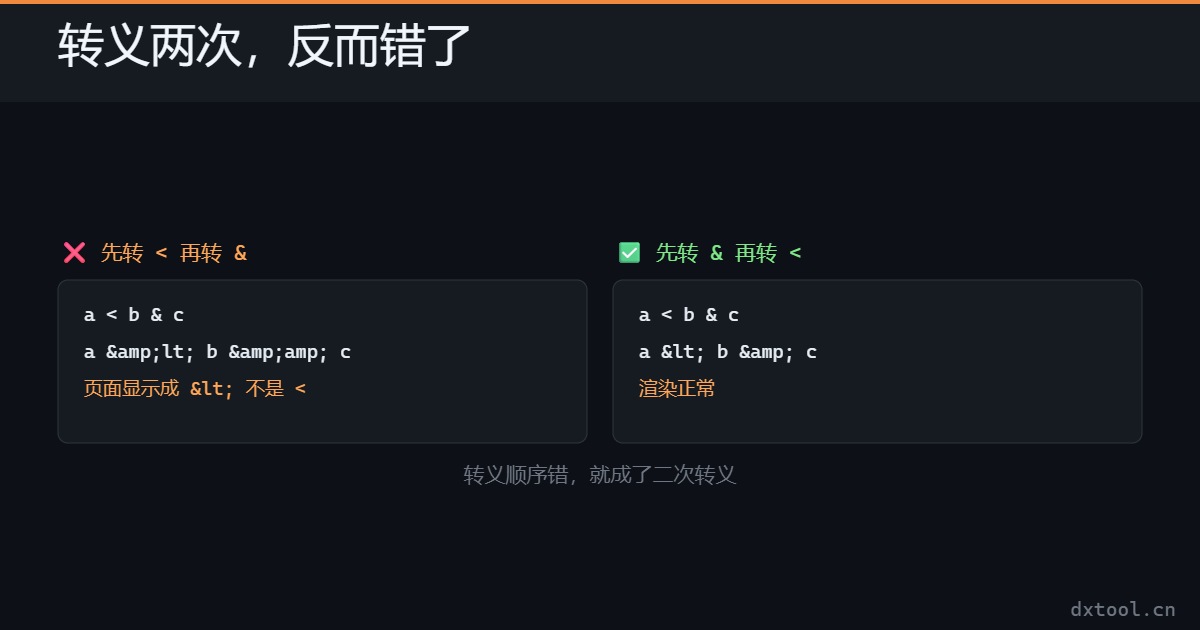
HTML 转义该用命名实体还是数字实体?文章从一次线上二次转义 bug 讲起,说清转义顺序、属性值与文本节点的差异、引号处理,以及 XSS 防护覆盖不到的 4 个场景:富文本白名单、JSON 内嵌 HTML、URL 参数回显与 CSS 表达式。附排查步骤与可直接复用的转义函数写法,配合在线转义工具可直接验证。
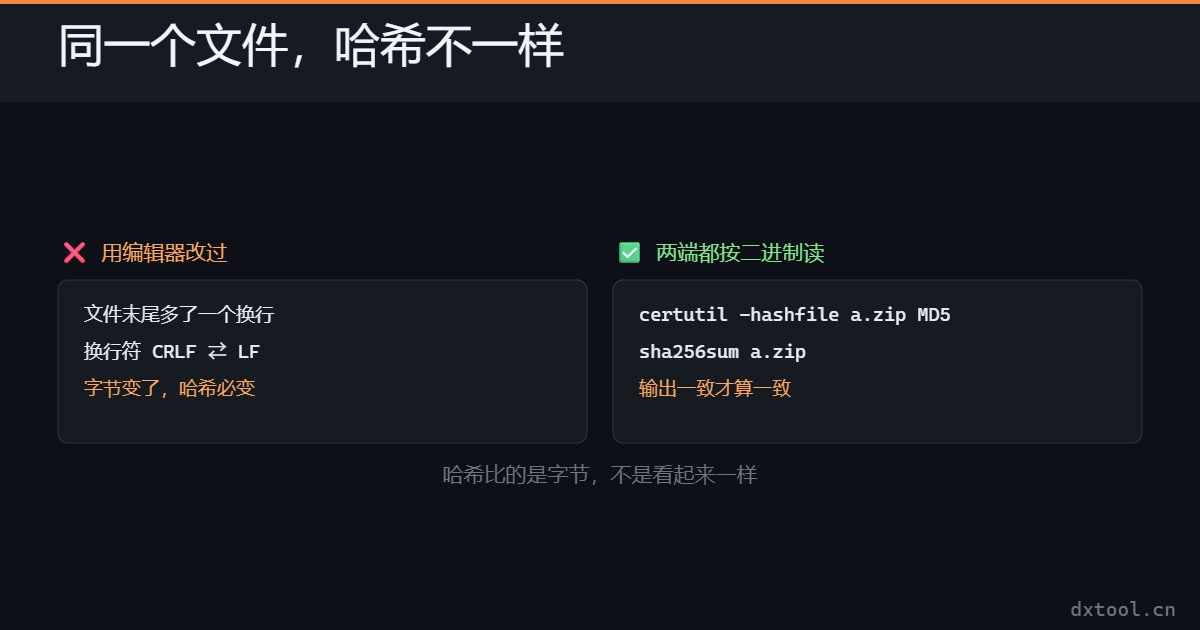
MD5/SHA 计算结果不一致?五个高频原因:CRLF 与 LF 换行差异、UTF-8 与 GBK 编码不同、BOM 与零宽字符不可见、大小写与空格处理不同、下载时附加了数据流。文章给出跨机器比对同一文件的具体定位方法,附命令行与代码示例,核对安装包和接口签名时按顺序排查,能避免反复下载大文件;先比对大小,再比对摘要。
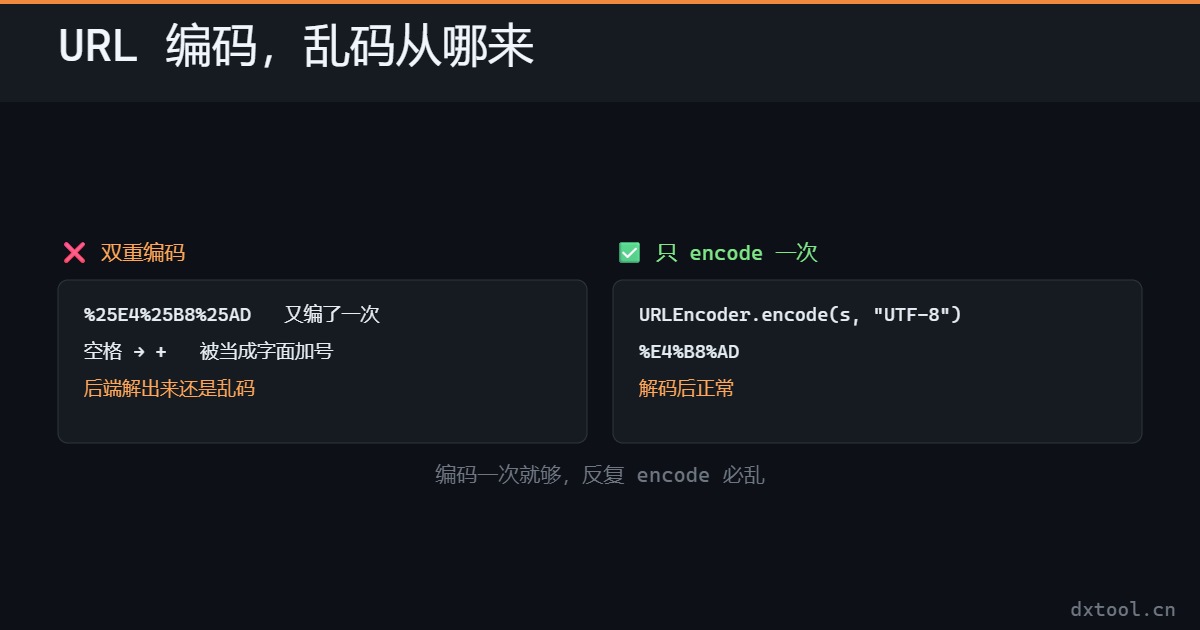
URL 编码与中文乱码排查:空格为什么有时是加号有时是 %20、中文被双重编码、表单与路径编码规则差异。给出各语言编码方法和对已编码串解码的正确顺序,快速定位乱码到底出在哪一步,也说明查询参数与服务端解码的配合方式。前后端各解码一次是最常见的原因,抓包对比原始串和实际收到的串,就能确认在哪一层出错。
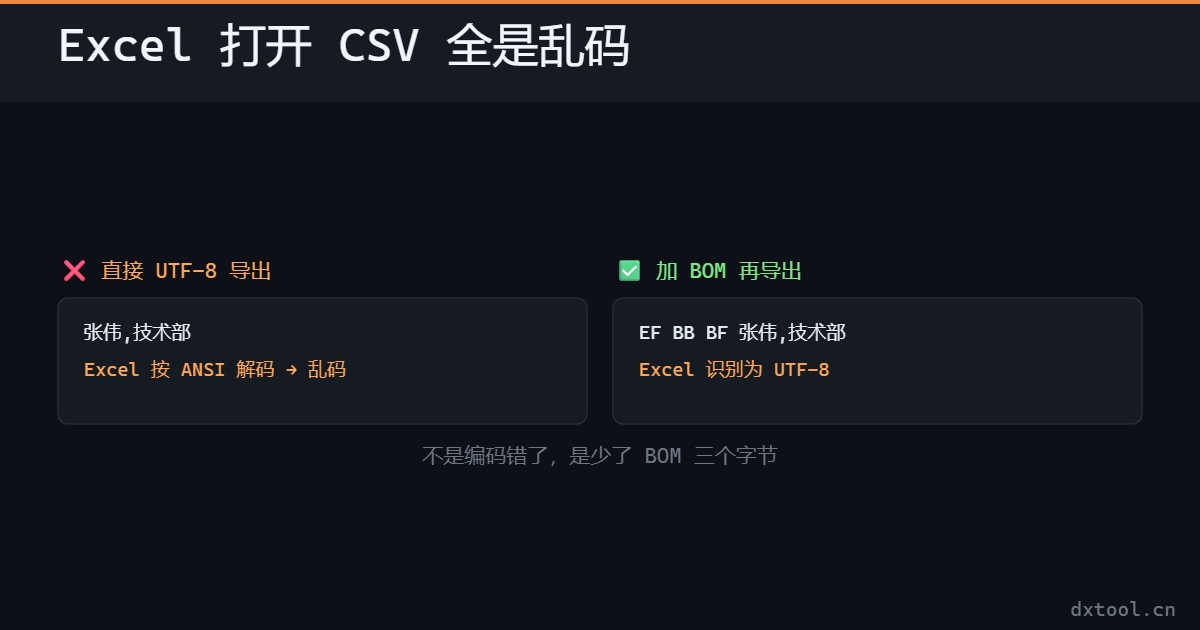
CSV 导出后 Excel 打开中文乱码?根因通常是缺少 UTF-8 BOM,Excel 按本地代码页解析就变成乱码。文章讲清 BOM 的作用与副作用,给出 Java、Python、Node 导出带 BOM 文件的写法,也说明改用 GBK 编码、分隔符与单元格内换行的兼容处理,附排查顺序与验证方法。