先给结论
chcp
type gbk.txt
type utf8.txt
chcp 65001 >nul & type utf8.txt
chcp 65001 >nul & findstr "中文" utf8.txt
java Hello
hello.exe
- 乱码只有两种:字节被按错的编码解释,或者输出时用错的编码写出去。先定位是哪一种,别急着
chcp。 chcp改的是当前窗口的解码表,不改文件,也不改程序内部编码。新开窗口回到系统默认的 936。type对带 BOM 的 UTF-8、UTF-16 会自动识别并转成当前代码页;无 BOM 的 UTF-8 直接按当前代码页裸读,936 下必乱。- UTF-8 BOM 的
.bat不是保险写法:cmd 不去 BOM,首行当成命令,报「不是内部或外部命令」,但退出码仍是 0。 - 重定向不是统一行为:
type、findstr原样搬字节;echo按当前代码页重新编码,所以chcp会改变echo落盘的字节。 - Java 17 在 Windows 固定用 GBK 写 stdout(
file.encoding=GBK),Go 固定写 UTF-8,chcp都改不了。 chcp 65001救不了findstr搜中文,也救不了 Java 输出;它只帮「按 UTF-8 解码的显示」。
演示用的文件
全文在 E:\cmd-demo\encoding 里操作,路径是本机真实路径。setup.ps1 会重建下面这些文件,每段示例都从重建后的状态开始;测试文件保留。
| 文件 | 内容或编码 |
|---|---|
gbk.txt |
两行中文,GBK 编码 |
utf8.txt |
同样两行,UTF-8 无 BOM |
utf8bom.txt |
同样两行,UTF-8 带 BOM |
utf16.txt |
同样两行,UTF-16 LE 带 BOM |
gbk.bat |
echo 你好,CMD,GBK 编码 |
utf8.bat |
同样的命令,UTF-8 无 BOM |
utf8bom.bat |
同样的命令,UTF-8 带 BOM |
Hello.java / Hello.class |
Java 打印中文与 file.encoding |
hello.go / hello.exe |
Go 打印中文 |
echo3.bat |
同一窗口先 936 后 65001,各 echo 一行到文件 |
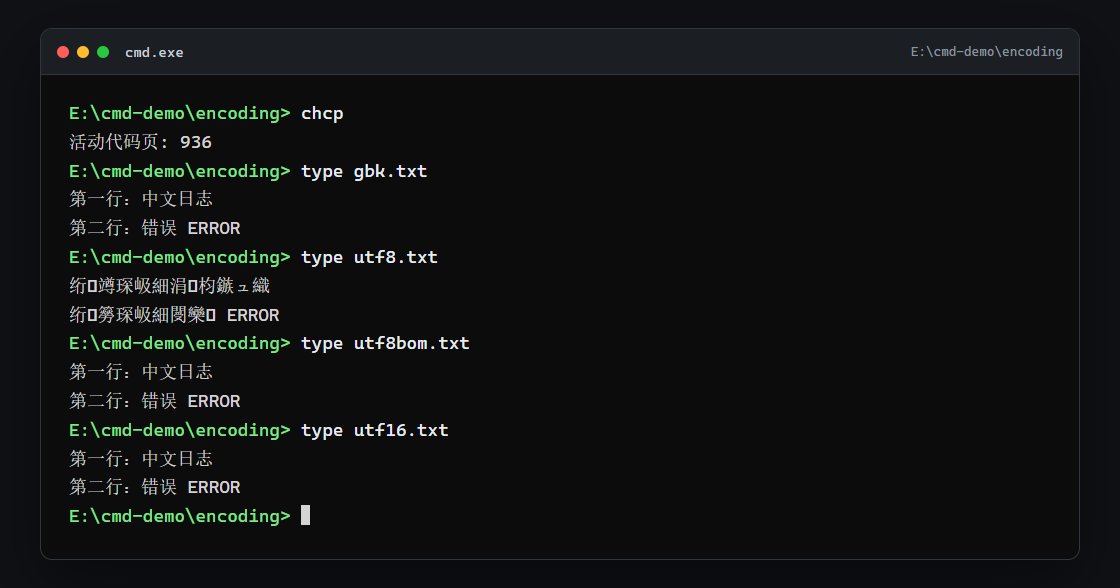
一、控制台先看一遍:一个文件,四种编码
chcp
type gbk.txt
type utf8.txt
type utf8bom.txt
type utf16.txt
输出:
活动代码页: 936
第一行:中文日志
第二行:错误 ERROR
绗竴琛岋細涓枃鏃ュ織
绗簩琛岋細閿欒 ERROR
第一行:中文日志
第二行:错误 ERROR
第一行:中文日志
第二行:错误 ERROR
同样是中文,GBK、UTF-8 BOM、UTF-16 三个都正常,只有 UTF-8 无 BOM 乱。这说明 type 不是「原样输出字节」:
- 文件开头有 BOM,
type能认出编码,转成当前代码页再写; - 没有 BOM,它只能假设文件就是当前代码页,字节原样送到屏幕,936 便把 UTF-8 的三字节序列拆成两个乱码字。
所以「type 看乱码 = 文件是 UTF-8」这个推断不成立,UTF-8 带 BOM 是正常的。
乱码的形状还能反推方向:UTF-8 被当成 GBK 解释时,三个字节会被拆成一个半汉字,出现「绗竴琛岋細」这种生造字;GBK 被当成 UTF-8 解释时,字节序列大多不合法,屏幕上是一串 � 替换符。前者是「字变样」,后者是「字消失」,看到哪种就知道该往哪个方向排查。
BOM 是几个固定字节:UTF-8 是 EF BB BF,UTF-16 LE 是 FF FE。用十六进制查看器打开文件头,一眼就能分辨有没有 BOM,比在编辑器里猜编码靠谱。
二、chcp 换的是解码表,不是文件
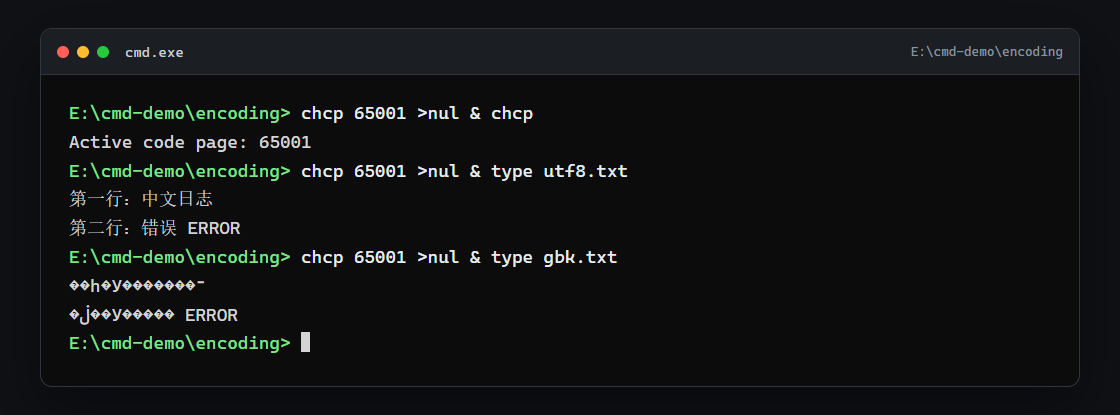
把窗口切到 65001 再看同样的两个文件:
chcp 65001 >nul & chcp
chcp 65001 >nul & type utf8.txt
chcp 65001 >nul & type gbk.txt
输出:
Active code page: 65001
第一行:中文日志
第二行:错误 ERROR
��һ�У�������־
�ڶ��У����� ERROR
UTF-8 无 BOM 正常了,GBK 反过来乱了。文件一个字节没动,变的只是窗口拿哪张表去解释字节。
注意第一行提示是英文——65001 下 cmd 自己的资源字符串按 UTF-8 输出。chcp 的作用范围只有一个窗口:关掉这个窗口、另开一个,chcp 又回到 936,因为默认代码页来自系统区域设置,chcp 不写注册表。
936 这个数字不是 cmd 自己定的,是中文 Windows 的 ANSI/OEM 代码页。cmd 启动时继承系统默认值,chcp 只改当前控制台对象;要永久改,得动区域设置里的「Beta 版:使用 Unicode UTF-8 提供全球语言支持」,那是系统级开关,不在本文范围。
三、源文件编码:BOM 是分水岭
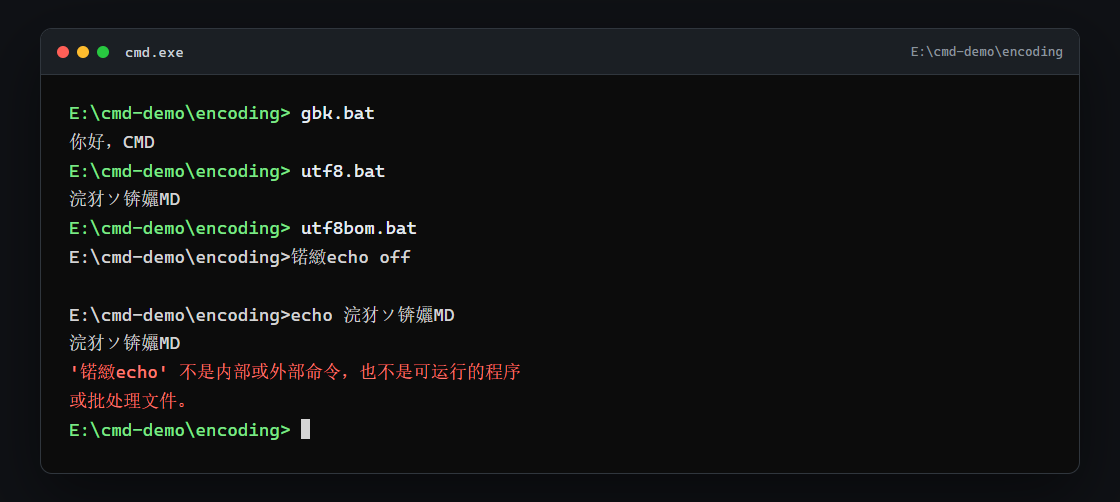
.bat 的情况比 .txt 更麻烦,因为 cmd 要先读脚本再执行:
gbk.bat
utf8.bat
utf8bom.bat
输出:
你好,CMD
浣犲ソ锛孋MD

E:\cmd-demo\encoding>锘緻echo off

E:\cmd-demo\encoding>echo 浣犲ソ锛孋MD
浣犲ソ锛孋MD
'锘緻echo' 不是内部或外部命令,也不是可运行的程序
或批处理文件。
- GBK 的 bat 在 936 下正常。
- UTF-8 无 BOM 的 bat 能被解析执行,但中文按 GBK 解释,
echo出来是乱码。 - UTF-8 BOM 的 bat 最坑:cmd 不剥 BOM,第一行变成
@echo off,报「不是内部或外部命令」。因为@echo off没生效,后面的命令被回显;最后一条echo成功,整个脚本退出码还是 0。
也就是说,带 BOM 的 bat 不一定不能用,但第一行一定报错,而且退出码不会告诉你。
四、重定向落盘:谁决定写出去的字节
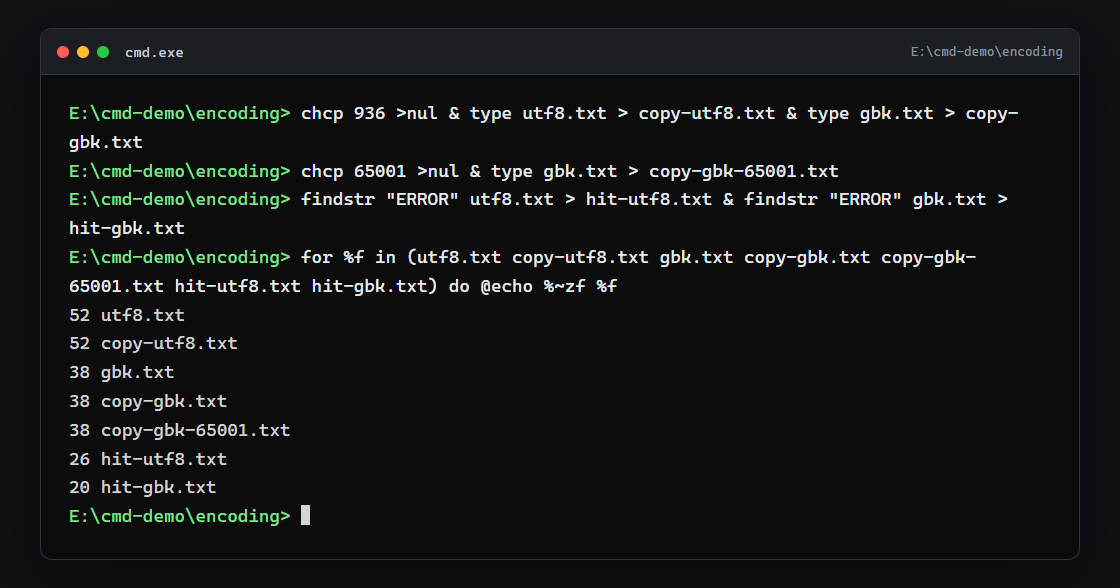
type 和 findstr 的重定向只是搬运:
chcp 936 >nul
type utf8.txt > copy-utf8.txt
type gbk.txt > copy-gbk.txt
chcp 65001 >nul
type gbk.txt > copy-gbk-65001.txt
findstr "ERROR" utf8.txt > hit-utf8.txt
findstr "ERROR" gbk.txt > hit-gbk.txt
for %f in (utf8.txt copy-utf8.txt gbk.txt copy-gbk.txt copy-gbk-65001.txt hit-utf8.txt hit-gbk.txt) do @echo %~zf %f
输出:
52 utf8.txt
52 copy-utf8.txt
38 gbk.txt
38 copy-gbk.txt
38 copy-gbk-65001.txt
26 hit-utf8.txt
20 hit-gbk.txt
拷贝前后字节数完全一致,切成 65001 也没变:type 不做转码,源文件是什么字节,落盘就是什么字节。findstr 命中的行同理,GBK 文件的命中行 20 字节,UTF-8 文件的命中行 26 字节。
echo 是另一套规则。用 echo3.bat 在同一个窗口里先 936 后 65001:
@echo off
chcp 936 >nul
set /p v=<gbk.txt
echo %v%>gbk-out.txt
chcp 65001 >nul
set /p w=<utf8.txt
echo %w%>utf8-out.txt
跑完看大小:
for %f in (gbk-out.txt utf8-out.txt) do @echo %~zf %f
输出:
18 gbk-out.txt
26 utf8-out.txt
同样的两行中文,936 下落盘 18 字节(GBK),65001 下落盘 26 字节(UTF-8)。echo 会用当前代码页重新编码,所以它受 chcp 影响,而 type、findstr 不受。
这也解释了一个常见错觉:重定向出来的文件在记事本里打开是好的,type 却是乱的。编辑器会按 BOM 或自动探测编码再转一次,CMD 不会,它只按当前代码页硬解释。判断文件到底是什么编码,看字节数比看编辑器标题栏可靠。
五、程序自己的输出编码:Java 一套,Go 一套
Java:
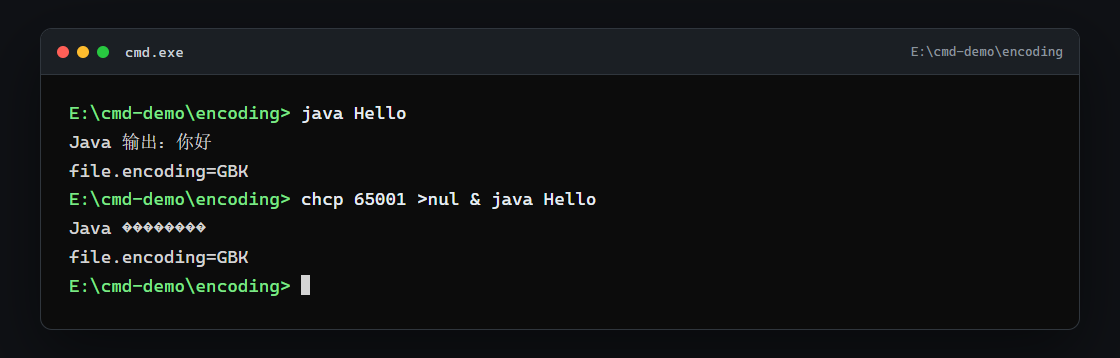
java Hello
chcp 65001 >nul & java Hello
输出:
Java 输出:你好
file.encoding=GBK
Java ��������
file.encoding=GBK
936 下正常;切到 65001 反而乱,file.encoding 仍是 GBK。Java 17 在 Windows 上用系统 ANSI 代码页写 stdout,chcp 改不了它。要它输出 UTF-8,得在启动参数上做文章,不是换个代码页。
Go:
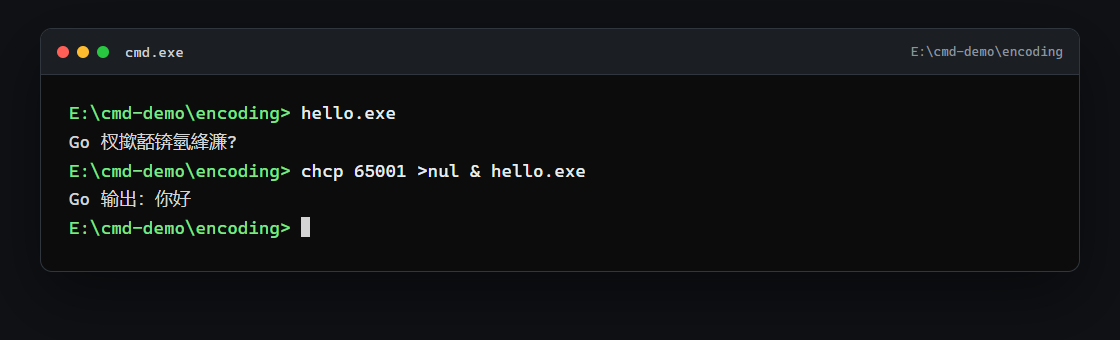
hello.exe
chcp 65001 >nul & hello.exe
输出:
Go 杈撳嚭锛氫綘濂?
Go 输出:你好
和 Java 相反:Go 永远写 UTF-8,936 的窗口按 GBK 解释就乱,65001 下正常。
同样是控制台程序,输出编码由运行时决定,窗口只能决定「怎么显示」。看到乱码先问一句:这串字节是谁写的。
六、findstr:中文搜索不吃 chcp
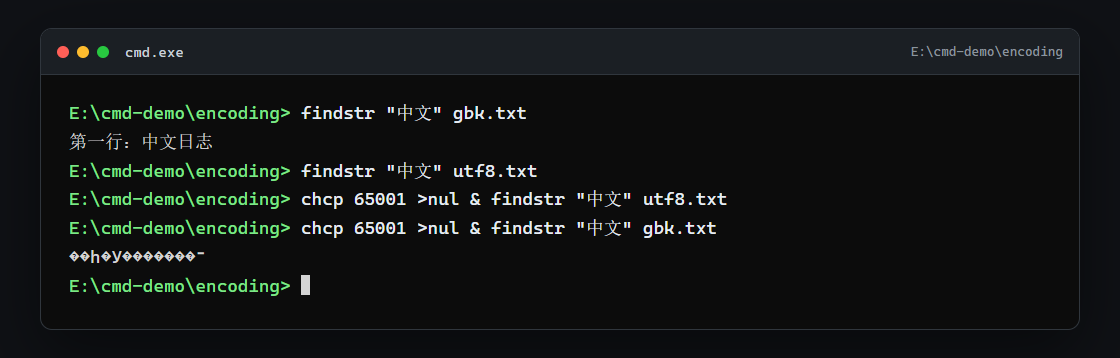
findstr "中文" gbk.txt
findstr "中文" utf8.txt
chcp 65001 >nul & findstr "中文" utf8.txt
chcp 65001 >nul & findstr "中文" gbk.txt
输出:
第一行:中文日志
��һ�У�������־
四条命令里只有第一条和第四条命中:936 下搜得到 GBK 文件,65001 下搜得到 GBK 文件(显示乱码)。两条针对 UTF-8 文件的都返回空,退出码 1。
findstr 的搜索串按系统 ANSI 代码页转换,不跟 chcp 走。所以「把窗口切到 65001,再用 findstr 搜中文」这个常见做法不成立。UTF-8 日志里的中文,要么先转成 GBK,要么换 findstr /g 也救不了,直接上 PowerShell 的 Select-String。
七、按顺序排查,别一上来就 chcp
- 看字节:文件是 GBK、UTF-8 还是 UTF-16,先用编辑器确认;不确定就看有没有 BOM。同一行中文,GBK 一个字两字节,UTF-8 一个字三字节,
for %f in (*.txt) do @echo %~zf %f比一比大小,也能看出用的是哪套编码。 - 看窗口:
chcp是多少。文件编码和代码页一致,type才正常。 - 看是显示乱还是内容乱:
type乱、findstr也搜不到,多半文件编码和代码页不一致;type正常但程序输出乱,问题在程序。 - 看程序:Java、Go、Python 各有各的默认输出编码,先查它写什么,再决定窗口用哪个代码页。
- 看落盘:重定向后的文件用
type交叉验证,或比字节数;echo和type的重定向不是一回事。
八、速查表
| 环节 | 现象 | 处理 |
|---|---|---|
| UTF-8 无 BOM 的 txt | 936 下 type 乱码 |
加 BOM,或 chcp 65001 后看 |
| UTF-8 BOM 的 txt | 936 下正常 | 不用改 |
| UTF-16 BOM 的 txt | 936 下正常 | type 自动识别,重定向前先想清楚目标程序认不认 |
| UTF-8 无 BOM 的 bat | 能跑,中文乱 | 存成 GBK,或统一 65001 |
| UTF-8 BOM 的 bat | 首行报「不是内部或外部命令」,退出码 0 | 去掉 BOM |
| GBK 文件切 65001 | type 乱码 |
切回 936,或先转 UTF-8 |
echo 重定向 |
936 落 GBK,65001 落 UTF-8 | 按目标消费方的编码选代码页 |
type 重定向 |
字节原样复制 | 不用管 chcp |
findstr 搜中文 |
65001 下仍搜不到 UTF-8 | 转码或换 Select-String |
| Java 输出 | 65001 下乱,file.encoding=GBK |
启动参数改编码,别改窗口 |
| Go 输出 | 936 下乱 | chcp 65001 |
编码问题几乎不会让退出码变化——BOM 的 bat 首行报错,整个脚本照样返回 0。判断有没有出错,不能只看退出码。
下一篇
编码这一关过了,下一篇查进程:某个程序还在不在跑、占了多少内存、是哪个 PID 在占端口。netstat -ano 怎么从端口拿到 PID,tasklist /FI 怎么按 PID 或名字反查,/V 和 /SVC 的「暂缺」是什么意思,netstat -b 为什么非管理员用不了,以及 taskkill 怎么先礼后兵。